Machine Learning Models Evaluation
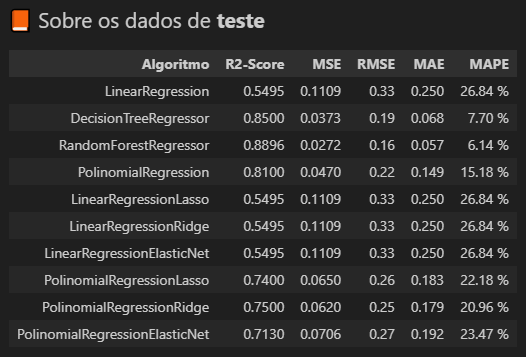
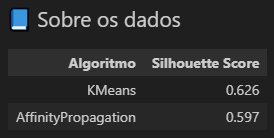
Comparativo de performance entre algoritmos de classificação, regressão e clusterização.
Por que esse estudo
Antes de construir soluções de ponta a ponta para problemas reais, foi importante entender como diferentes algoritmos de Machine Learning se comportam na prática, não só na teoria. Esse estudo comparou o desempenho de vários modelos nas três frentes principais: classificação, regressão e clusterização.
O que foi comparado
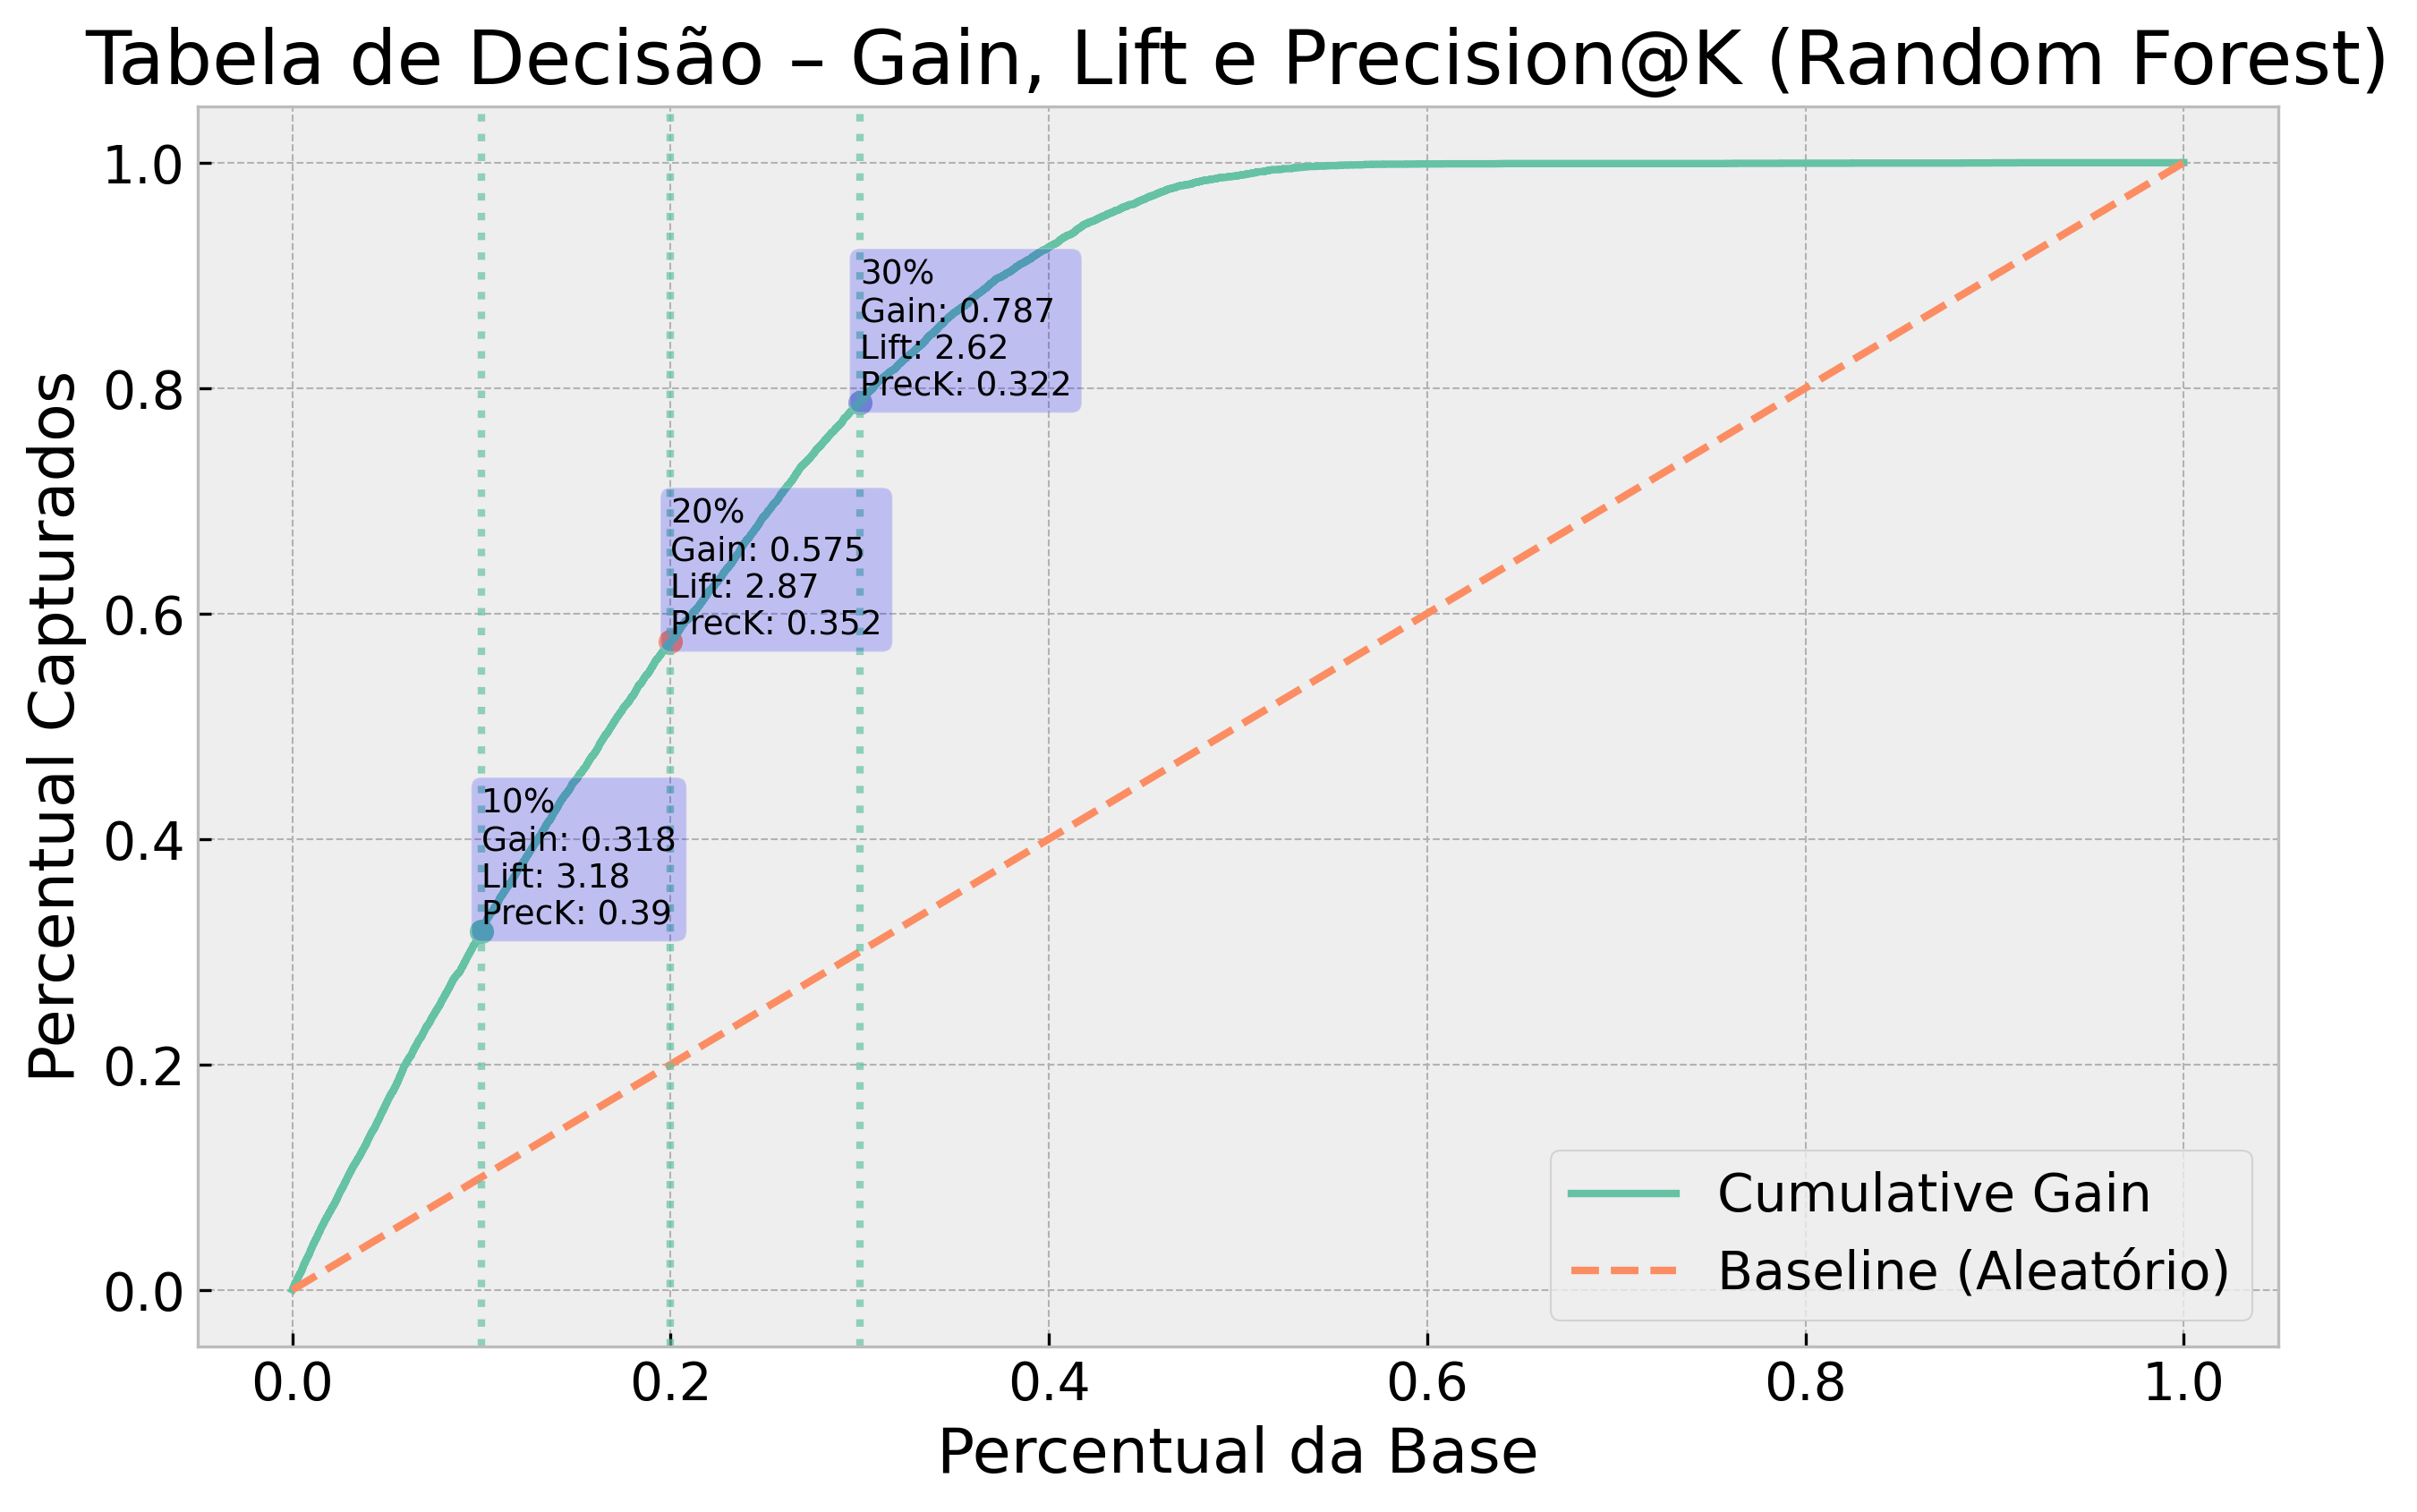
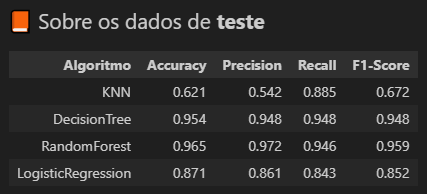
Dezenas de configurações de algoritmos testadas nas três frentes (entre elas KNN, Árvore de Decisão, Random Forest, Regressão Linear e Regressão Logística), avaliadas com as métricas adequadas a cada tarefa e comparadas em treino, validação e teste para identificar sinais de overfitting e underfitting.
O que ficou claro
Modelos baseados em árvore (Random Forest, Decision Tree) superaram consistentemente métodos mais simples como KNN e Regressão Linear nas três frentes, mas com mais risco de overfitting se não forem bem regularizados. Não existe um algoritmo "melhor" universal, a escolha certa depende do equilíbrio entre desempenho, interpretabilidade e tempo de treino que cada problema pede.
Resultado
Forest na classificação
Forest na regressão
com KMeans na clusterização